Tips Mengoptimalkan GPU untuk AI agar Stabil, Strategi Praktis Tingkatkan Kecepatan Pemrosesan

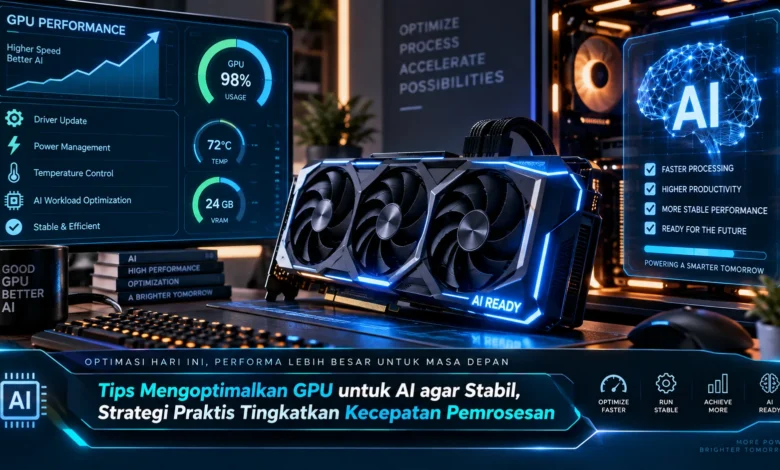
GPU menjadi komponen penting ketika menjalankan berbagai workload AI karena mampu menangani banyak operasi komputasi secara paralel. Namun, kartu grafis dengan spesifikasi tinggi belum tentu memberikan performa maksimal apabila VRAM, suhu, driver, framework, hingga konfigurasi model tidak dikelola dengan tepat. Optimasi yang seimbang dapat membantu meningkatkan kecepatan sekaligus menjaga stabilitas sistem, sehingga pemanfaatan TEKNOLOGI AI menjadi lebih efisien untuk inferensi maupun pekerjaan komputasi lainnya.
Pahami Karakter Workload AI agar GPU Bekerja Optimal
Tahap pertama untuk meningkatkan performa kartu grafis dimulai dengan mengenali bagaimana aplikasi AI memanfaatkan sumber daya. Masing masing workload mempunyai karakteristik penggunaan hardware yang tidak sama. Sebagian model lebih banyak membutuhkan kapasitas VRAM, sementara proses lainnya membutuhkan bandwidth serta kemampuan pemrosesan yang tinggi.
Pemantauan hardware membantu melihat bagaimana sumber daya digunakan. Beban kartu grafis, konsumsi memory GPU, penggunaan prosesor, memory sistem, suhu, serta throughput sebaiknya diamati selama model melakukan inferensi. Apabila utilisasi kartu grafis rendah tetapi prosesor terus berada pada beban berat, konfigurasi workload perlu diperiksa sebelum meningkatkan kemampuan GPU. Cara seperti ini membantu pengguna meningkatkan performa TEKNOLOGI secara lebih efektif.
Manajemen Memory GPU Menjadi Kunci Performa AI
Kapasitas memori grafis menjadi faktor utama saat memproses workload kecerdasan buatan. Data model perlu ditempatkan pada memory GPU, sementara proses inferensi juga menghasilkan kebutuhan memory tambahan. Apabila memory GPU terlalu penuh sebelum workload meningkat, model dapat mengalami masalah saat membutuhkan alokasi tambahan.
Pengguna dapat mengurangi aplikasi lain yang memakai akselerasi GPU. Browser, program kreatif, game, editor multimedia, dan berbagai aplikasi berbasis GPU berpotensi mengurangi memory yang tersedia untuk model. Memberikan ruang cadangan pada VRAM dapat mengurangi tekanan ketika model membutuhkan alokasi tambahan. Pengelolaan memory seperti ini sering memberikan dampak nyata tanpa harus mengganti hardware.
Model AI Bisa Berjalan Lebih Efisien dengan Quantization
Teknik representasi numerik yang lebih ringkas dapat digunakan agar model AI menggunakan sumber daya lebih sedikit. Model yang menyimpan parameter dengan format numerik lebih berat dapat memberikan tekanan lebih tinggi pada memory GPU. Menggunakan quantization yang sesuai berpotensi menekan konsumsi VRAM secara signifikan.
Konfigurasi quantization perlu dipilih berdasarkan workload. Pengaturan yang lebih agresif dapat memberikan penghematan memory lebih besar, namun hasil pemrosesan tertentu dapat mengalami perbedaan. Pengujian beberapa konfigurasi dapat membantu menemukan keseimbangan antara kualitas dan performa. Fokus utamanya ialah menjaga keseimbangan antara penggunaan VRAM, kecepatan, dan hasil.
Konfigurasi Batch Size Membantu Menjaga Performa GPU
Batch size memiliki pengaruh terhadap penggunaan GPU. Memproses lebih banyak data secara bersamaan dapat memanfaatkan paralelisme GPU dengan lebih baik, tetapi kebutuhan memory biasanya ikut bertambah. Menggunakan batch terlalu besar dapat membuat sistem kehilangan stabilitas.
Context juga perlu diperhatikan pada model yang memproses urutan panjang. Jumlah token yang besar berpotensi menambah konsumsi VRAM. Jika tugas hanya membutuhkan informasi terbatas, memaksakan context besar justru dapat memboroskan sumber daya. Menentukan nilai awal yang aman lalu menguji peningkatan secara perlahan menjadi strategi praktis untuk menjaga TEKNOLOGI AI tetap responsif.
Kurangi Bottleneck dengan Pembagian Workload yang Tepat
Kemampuan komputasi kartu grafis bukan satu satunya faktor ketika komponen lain tidak mampu menyediakan data dengan cukup cepat. CPU dapat menjalankan preprocessing serta berbagai tugas pendukung, sementara RAM serta media penyimpanan berperan dalam menyediakan input. Ketika kecepatan antarbagian tidak seimbang, GPU dapat menunggu data meskipun memiliki kemampuan komputasi tinggi.
Pengalihan sebagian model menuju memory sistem perlu diatur secara hati hati. Ketika kebutuhan model lebih besar daripada VRAM yang tersedia, sebagian komponen dapat ditempatkan pada RAM. Akan tetapi transfer informasi secara berulang dapat menjadi bottleneck baru. Pembagian workload yang seimbang dapat membantu menjaga stabilitas sekaligus mempertahankan kecepatan.
Jaga Suhu dan Software agar GPU Tetap Stabil
GPU yang menjalankan workload AI dalam waktu panjang dapat menghasilkan panas dalam jumlah cukup besar. Jika suhu meningkat terlalu jauh, sistem berpotensi melakukan penyesuaian performa untuk mengendalikan panas. Penurunan frekuensi tersebut berpotensi menyebabkan performa turun setelah workload berjalan lama.
Aliran udara dan kebersihan sistem pendinginan perlu diperhatikan. Komponen perangkat lunak perlu disesuaikan agar akselerasi berjalan dengan benar. Driver yang sesuai, framework yang kompatibel, serta library akselerasi yang tepat dapat membuat pemanfaatan kartu grafis menjadi lebih efektif. Perpaduan pendinginan serta konfigurasi perangkat lunak tersebut membantu TEKNOLOGI komputasi berjalan cepat tanpa mengabaikan stabilitas.
Kesimpulan
Mengoptimalkan GPU untuk AI membutuhkan pendekatan yang seimbang antara kecepatan dan stabilitas. VRAM, quantization, batch, context, CPU, RAM, transfer data, temperatur, driver, dan framework harus dikelola agar tidak saling menciptakan bottleneck. Dengan memahami hubungan antarbagian tersebut, pemrosesan dapat menjadi lebih cepat sekaligus tetap stabil.
Monitoring menjadi bagian penting dalam menemukan konfigurasi terbaik. Setiap model dan perangkat dapat memberikan hasil berbeda, maka pengaturan sebaiknya disesuaikan berdasarkan hasil nyata. Pemanfaatan TEKNOLOGI kecerdasan buatan menjadi lebih efisien saat seluruh komponen bekerja selaras. Pembaca dapat menerapkan optimasi satu per satu untuk menemukan kombinasi kecepatan dan stabilitas terbaik pada perangkat masing masing.