Supermicro dan SambaNova Rancang Server Inferensi AI dengan Pembagian Beban Pemrosesan

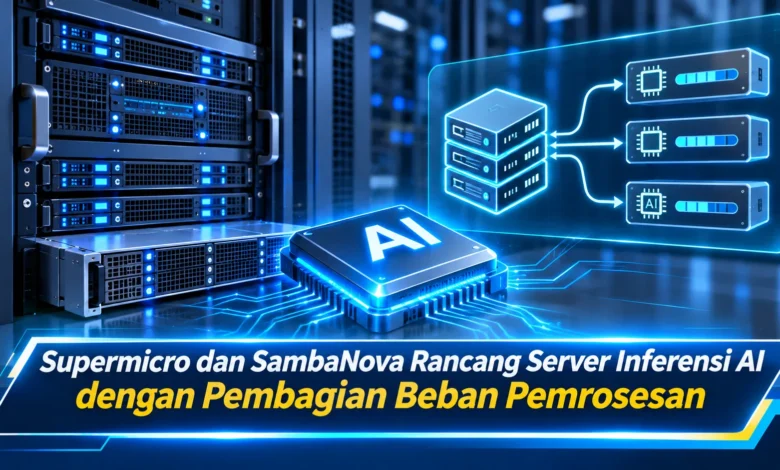
Supermicro dan SambaNova mengumumkan kolaborasi strategis pada 3 November 2026 untuk mengembangkan server inferensi kecerdasan buatan dengan sistem pembagian beban pemrosesan. Kerja sama ini menggabungkan GPU NVIDIA dan chip SambaNova SN50 Reconfigurable Dataflow Unit (RDU) dalam satu infrastruktur pusat data. Melalui pendekatan disaggregated inference, proses memahami masukan pengguna dan menghasilkan respons AI dijalankan oleh perangkat keras yang berbeda sesuai karakteristik pekerjaannya. Inovasi TEKNOLOGI tersebut dirancang untuk meningkatkan efisiensi, mempercepat respons model bahasa besar, serta mendukung kebutuhan agentic AI. Kedua perusahaan merencanakan penggunaan awal 10.000 chip SN50 untuk membangun sistem inferensi yang dapat diterapkan pada berbagai lingkungan komputasi.
Kolaborasi Supermicro dan SambaNova Menghadirkan Server AI Heterogen
Supermicro dan SambaNova mengumumkan kerja sama strategis untuk mengembangkan sistem pemrosesan kecerdasan buatan yang memanfaatkan perangkat keras dengan fungsi berbeda. Kolaborasi tersebut mengutamakan pemisahan tahapan inferensi dengan mengintegrasikan GPU NVIDIA dan RDU SambaNova. Berkat pembagian tugas tersebut, setiap perangkat keras dapat menangani pekerjaan yang sesuai. Sasaran penting dari kolaborasi tersebut adalah mengoptimalkan penggunaan kapasitas komputasi ketika beban kerja semakin kompleks.
Berdasarkan rencana kolaborasi, Supermicro menargetkan integrasi awal sebanyak 10.000 chip SambaNova SN50. Target integrasi awal tersebut menjadi dasar pengembangan kapasitas inferensi. Supermicro akan menangani integrasi perangkat keras, pengujian, distribusi, dan dukungan teknis. Sementara itu, SambaNova membantu menyesuaikan perangkat lunak dengan akselerator yang digunakan. Pembagian tanggung jawab tersebut diharapkan mempermudah penerapan sistem bagi operator pusat data dan penyedia layanan cloud.
Cara Kerja Disaggregated Inference dalam Membagi Beban Pemrosesan AI
Prinsip pemrosesan yang digunakan dalam rancangan server inferensi terbaru adalah disaggregated inference. Pendekatan komputasi tersebut merujuk pada pembagian pekerjaan model AI. Bagian pertama inferensi dinamakan prefill, yaitu aktivitas memproses masukan pengguna. Ketika masukan sedang dianalisis, perangkat memproses sejumlah operasi matematika secara bersamaan. Perangkat pemrosesan paralel NVIDIA dipilih untuk menjalankan tahap ini karena sesuai dengan karakteristik pekerjaan yang intensif terhadap komputasi.
Proses berikutnya dikenal sebagai decoding, yaitu proses menghasilkan token respons secara bertahap. Berbeda dari prefill, decoding banyak bergantung pada kecepatan akses data, terutama ketika model memiliki banyak parameter. Untuk menangani karakteristik tersebut, SambaNova menempatkan akselerator SN50 pada tahap decode. Chip tersebut dikembangkan untuk mempercepat generasi token. Melalui pembagian ini, GPU dapat berfokus pada prefill, sedangkan pembentukan respons diproses melalui RDU.
Peran Reconfigurable Dataflow Unit untuk Mempercepat Decoding
Chip SN50 dikenal sebagai RDU generasi kelima dari SambaNova. Chip inferensi tersebut dirancang untuk menangani model AI berukuran besar. Keunggulan arsitektur yang ditawarkan adalah pengoptimalan perpindahan informasi antarunit pemrosesan. Ketika model menghasilkan respons, perpindahan data dapat menentukan kecepatan keluaran. Dengan mempertimbangkan karakteristik tersebut, SambaNova mengembangkan pendekatan komputasi berbasis dataflow. Pendekatan ini berpotensi meningkatkan throughput inferensi.
Kombinasi RDU dan akselerator NVIDIA berbeda dari penggunaan akselerator dengan tugas yang sama. Dalam rancangan tersebut, pekerjaan dibagi berdasarkan karakteristik masing-masing chip. Komponen grafis mengerjakan pemrosesan masukan berintensitas komputasi tinggi, sementara RDU mempercepat pembentukan token. Namun demikian, koordinasi GPU dan RDU menjadi faktor penting. Ketika integrasi perangkat tidak optimal, efisiensi sistem mungkin tidak mencapai target. Dengan alasan tersebut, konfigurasi jaringan serta pemrosesan harus disesuaikan.
Strategi Supermicro Menyediakan Server GPU dan RDU untuk Pusat Data
Sebagai bagian dari pengembangan sistem, Supermicro mengintegrasikan teknologi SN50 melalui Data Center Building Block Solutions. Konsep Data Center Building Block Solutions adalah strategi penyediaan komponen infrastruktur pusat data. Dengan arsitektur modular ini, penyedia layanan dapat memilih susunan komputasi yang sesuai. Dalam konteks inferensi AI, GPU NVIDIA dan RDU SambaNova menjadi komponen saling melengkapi. Perusahaan penyedia server tersebut berperan menjamin infrastruktur memenuhi persyaratan kompatibilitas.
Selain integrasi perangkat keras, Supermicro bertanggung jawab terhadap pengujian serta pemeliharaan. Dukungan tersebut melibatkan dukungan on-site apabila diperlukan. Sementara itu, insinyur SambaNova membantu penyetelan model agar dapat berjalan dengan baik pada SN50. Kolaborasi teknis ini diharapkan mengurangi kompleksitas integrasi sistem. Dengan demikian, proses pengadaan perangkat berpotensi menjadi lebih praktis. Namun demikian, kompatibilitas model harus dipastikan secara khusus.
Server Inferensi Supermicro dan SambaNova Mendukung Kebutuhan Agentic AI
Fokus pasar utama dari pengembangan server inferensi heterogen adalah agentic AI. Konsep kecerdasan buatan ini merujuk pada sistem yang dapat menjalankan rangkaian tugas berdasarkan perintah yang harus diselesaikan secara bertahap. Berbeda dari chatbot sederhana, agen AI dapat melakukan banyak permintaan model. Dalam berbagai tahapan pekerjaan, berpotensi membutuhkan respons yang panjang. Ketika aktivitas agen semakin kompleks, efisiensi pemrosesan respons memengaruhi keseluruhan pekerjaan. Dengan pembagian prefill dan decode, beban tersebut diharapkan dapat ditangani lebih efisien.
Pada tahap distribusi awal, Supermicro dan SambaNova menargetkan penyedia NeoCloud serta sovereign cloud. NeoCloud merupakan penyedia komputasi cloud yang berfokus pada kebutuhan AI. Sementara itu, sovereign cloud dirancang memenuhi kebutuhan kedaulatan data organisasi atau negara. Setelah tahap awal, distribusi direncanakan meluas ke organisasi yang mengoperasikan infrastruktur internal. Rencana distribusi bertahap ini mendukung penerapan sistem pada berbagai skala operasional.
Selain mempercepat inferensi, kombinasi akselerator yang direncanakan berpotensi membantu pengelolaan kebutuhan daya. SambaNova menyatakan, SN50 dapat menjalankan inferensi model besar tanpa kebutuhan kepadatan daya rak yang ekstrem. Kemampuan yang ditargetkan tersebut dapat membantu operator menambah kapasitas tanpa membangun fasilitas baru. Sebagai manfaat potensial lainnya, operator tidak harus langsung mengganti seluruh akselerator lama. Walaupun manfaat tersebut menjanjikan, hasil penggunaan nyata bergantung pada model, beban kerja, dan fasilitas. Belum tersedia hasil pengukuran terperinci untuk konfigurasi Supermicro terbaru.
Peluang Teknologi Disaggregated Inference bagi Komputasi Kecerdasan Buatan
Kolaborasi Supermicro dan SambaNova menunjukkan perkembangan penting dalam pengembangan TEKNOLOGI pusat data. Berkat pemisahan pekerjaan inferensi, akselerator grafis menangani komputasi awal, sedangkan chip RDU digunakan untuk proses decoding. Rancangan pembagian pekerjaan tersebut berpotensi mempercepat inferensi model besar. Target penggunaan sepuluh ribu unit SN50 menjadi dasar ekspansi kapasitas inferensi. Meski pendekatan teknisnya menarik, hasil efisiensi belum dapat digeneralisasi tanpa benchmark. Berkat integrasi yang terus ditingkatkan, server heterogen dapat memperluas pilihan komputasi perusahaan. Bagaimana pandangan Anda mengenai penggabungan GPU dan RDU untuk inferensi AI? Sampaikan pandangan Anda mengenai masa depan komputasi kecerdasan buatan yang lebih efisien.