Intel Ungkap Kemampuan GPU D Series Berbasis Crescent Island untuk Pemrosesan AI

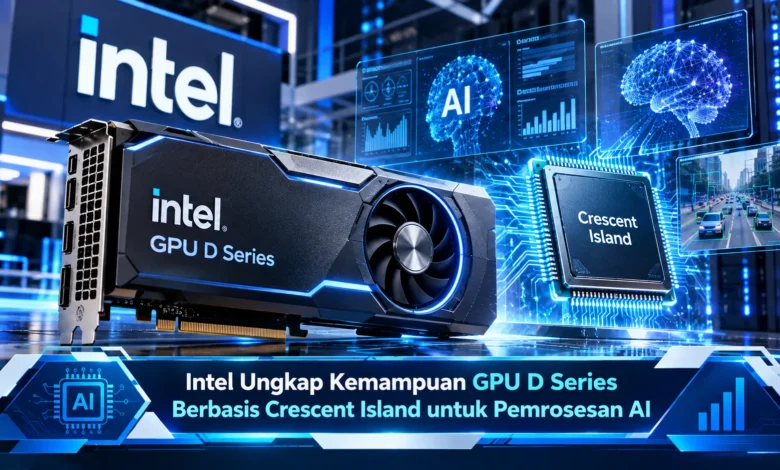
Intel memperkenalkan rincian terbaru GPU D Series berbasis arsitektur Crescent Island dalam ajang Open Compute Project Global Summit pada 12 Oktober 2026. Akselerator ini dirancang khusus untuk kebutuhan pemrosesan kecerdasan buatan atau AI inference di pusat data, dengan kapasitas memori hingga 480 GB LPDDR5X, bandwidth 1,5 TB/s, serta performa komputasi mencapai 1,3 petaflops FP8. Berbekal arsitektur Xe3P dan konsumsi daya yang dirancang berada dalam batas 350 watt, Intel berupaya menghadirkan teknologi pemrosesan AI yang lebih efisien. GPU D Series juga ditujukan untuk menjalankan model bahasa besar, sistem agen AI, dan berbagai layanan inferensi berskala perusahaan.
Pengumuman Intel GPU D Series Perkuat Persaingan Akselerator AI
Pertumbuhan industri komputasi AI semakin meningkatkan permintaan perangkat keras khusus AI. Dalam beberapa tahun terakhir, perusahaan teknologi berupaya mengatasi hambatan berupa konsumsi daya yang tinggi. Untuk menjawab kebutuhan tersebut, Intel mengumumkan GPU D Series sebagai platform GPU yang dioptimalkan untuk inferensi. Akselerator terbaru tersebut dikembangkan menggunakan nama proyek Crescent Island yang mulai diumumkan pada tahun sebelumnya. Melalui pengumuman terbaru, Intel memperjelas kemampuan perangkat kerasnya.
Pengumuman GPU D Series berlangsung pada konferensi OCP Global Summit. Konferensi industri tersebut menjadi tempat pembahasan infrastruktur komputasi terbuka. Produsen semikonduktor tersebut mengarahkan GPU D Series sebagai perangkat komputasi yang mengutamakan kapasitas memori. Tidak seperti GPU yang difokuskan pada permainan, perangkat ini difokuskan pada aplikasi kecerdasan buatan. Oleh sebab itu, kemampuan GPU D Series perlu dinilai berdasarkan beban AI. Arah desain tersebut memberikan alternatif dalam pengembangan infrastruktur AI.
Kemampuan Crescent Island dalam Mendukung Inferensi Berkapasitas Besar
Keunggulan teknis yang menonjol Intel GPU D Series adalah dukungan memori LPDDR5X sebesar 480 GB. Ketersediaan ruang penyimpanan sementara tersebut dirancang untuk memenuhi kebutuhan model AI berukuran besar. Selain itu, perusahaan menyebut bandwidth memori hingga 1,5 TB/s. Bandwidth tinggi mendukung pemindahan informasi selama inferensi. Pada tugas AI dengan banyak parameter, kecepatan akses memori dapat memengaruhi keluaran token. Walaupun spesifikasinya menjanjikan, hasil penggunaan dapat berbeda menurut model.
Dari sisi pemrosesan, GPU D Series menggunakan Xe3P yang mendukung operasi komputasi intensif. Perusahaan menjelaskan, perangkat ini menawarkan performa teoretis hingga 1,3 petaflops FP8. Presisi numerik FP8 membantu meningkatkan efisiensi komputasi pada model yang kompatibel. Meski demikian, angka teoretis tidak selalu tercapai pada seluruh pekerjaan. Sebagai bagian dari rancangan perangkat, Intel menetapkan batas daya sekitar 350 watt. Rancangan tersebut bertujuan menyeimbangkan kapasitas dan efisiensi.
Arsitektur Crescent Island untuk Komputasi Paralel dan Inferensi
Rancangan pemrosesan Intel Xe3P menjadi fondasi utama GPU D Series. Melalui rincian arsitektur yang tersedia, Crescent Island memiliki 32 Xe core serta 256 XMX engine. Teknologi Xe Matrix Extensions adalah akselerator yang menangani perhitungan matriks. Pada jaringan saraf modern, banyak proses melibatkan komputasi matriks. Karena itu, pemrosesan khusus matriks membantu menjalankan beban jaringan saraf. Melalui penggabungan Xe core dan XMX, GPU D Series mendukung berbagai operasi inferensi.
Dalam proses inferensi, sistem komputasi menjalankan perhitungan terhadap bobot jaringan. Aktivitas komputasi tersebut memerlukan koordinasi antara unit pemrosesan dan memori. Kombinasi arsitektur Xe3P serta mesin matriks membantu menangani perhitungan AI. Namun demikian, penggunaan sumber daya membutuhkan implementasi model yang sesuai. Jika runtime belum mendukung jalur pemrosesan tertentu, kecepatan pemrosesan belum tentu mencapai potensi perangkat. Karena alasan tersebut, optimalisasi perangkat lunak diperlukan untuk mencapai performa terbaik.
Intel GPU D Series Mendukung Model AI hingga 300 Miliar Parameter
Salah satu kemampuan yang diunggulkan GPU D Series adalah pemrosesan jaringan saraf dengan parameter sangat banyak. Perusahaan menyebut bahwa kapasitas perangkat memungkinkan pemrosesan model sekitar 300 miliar parameter. Dukungan tersebut memanfaatkan kapasitas memori perangkat. Namun demikian, penggunaan memori dapat berubah menurut metode kuantisasi. Tidak hanya untuk menyimpan jaringan saraf, ruang penyimpanan sementara juga dibutuhkan. Dengan mempertimbangkan hal tersebut, penerapan produksi membutuhkan pengujian beban kerja.
Ketika satu kartu belum mencukupi, Intel mengembangkan konfigurasi pemrosesan menggunakan banyak GPU. Menurut perusahaan, konfigurasi delapan GPU D Series dirancang mendukung model dengan lebih dari satu triliun parameter. Pendekatan ini memungkinkan distribusi beban komputasi. Ketika perangkat dijalankan bersama, efisiensi bergantung pada pembagian model serta transfer data. Dengan mempertimbangkan kebutuhan sistem, hasil pemrosesan bergantung pada rancangan komunikasi. Meski demikian, sistem tersebut membuka peluang pemrosesan model berukuran sangat besar.
Keunggulan Kartu PCIe Intel untuk Infrastruktur AI Enterprise
Selain menawarkan kapasitas memori besar, Intel memperhatikan kemudahan penerapan perangkat dalam lingkungan pusat data perusahaan. Akselerator tersebut hadir dalam form factor PCI Express yang mendukung integrasi dengan sistem yang sesuai. Intel juga mengandalkan mekanisme air cooling. Pendekatan tersebut mempermudah penerapan tanpa infrastruktur cairan khusus. Meski rancangan tersebut menawarkan kemudahan, perencanaan pendinginan pusat data masih diperlukan.
Dalam operasional pusat data, biaya perangkat keras bukan satu-satunya pertimbangan. Penggunaan listrik, pendinginan, dan pemeliharaan menentukan efisiensi keseluruhan. Melalui rancangan daya sekitar 350W, Intel berusaha menghadirkan keseimbangan antara performa dan efisiensi. Walaupun batas daya dapat menjadi indikator, efisiensi aktual memerlukan pengukuran throughput per watt. Di samping kebutuhan listrik, ketersediaan perangkat lunak harus dievaluasi dalam pengadaan infrastruktur.
Kesimpulan Kemampuan Intel GPU D Series untuk Inferensi AI
Pengenalan spesifikasi akselerator AI terbaru Intel menunjukkan langkah penting dalam ekosistem komputasi AI modern. Dengan memanfaatkan teknologi pemrosesan Xe3P, dukungan memori berkapasitas tinggi, bandwidth 1,5 TB/s, dan daya pemrosesan puncak 1,3 petaflops, Intel menghadirkan alternatif akselerasi AI untuk perusahaan. Rancangan daya 350 watt juga menjadi bagian dari pendekatan efisiensi. Meski kemampuan perangkat menjanjikan, performa nyata masih memerlukan evaluasi.
Dalam tahapan ketersediaan produk, Intel mengonfirmasi tahap evaluasi perangkat oleh pelanggan. Akan tetapi, jadwal ketersediaan luas belum diumumkan secara pasti. Intel juga mendorong penggunaan fondasi perangkat lunak yang seragam bersama mitra industri pusat data. Melalui kolaborasi tersebut, GPU D Series berpotensi menjadi alternatif dalam pasar inferensi. Apa pendapat Anda, apakah akselerator AI berbasis Xe3P berpotensi membantu menurunkan biaya inferensi? Sampaikan pandangan Anda mengenai perkembangan akselerator pusat data.