Peneliti Google Kembangkan Kerangka Sleep agar Model AI Dapat Mempertahankan Pengetahuan Lama

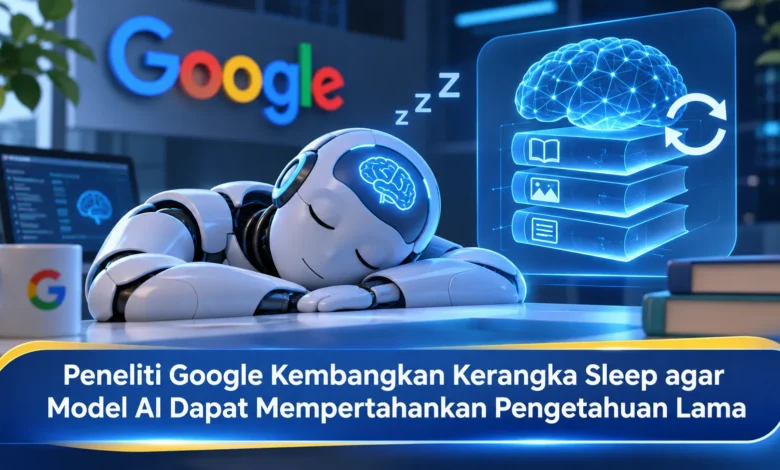
Google Research memperkenalkan pendekatan baru dalam pengembangan kecerdasan buatan melalui kerangka Sleep yang dirancang untuk membantu model AI mempelajari informasi baru tanpa mudah melupakan pengetahuan sebelumnya. Penelitian yang dipublikasikan pada 27 Oktober 2026 ini berfokus pada masalah catastrophic forgetting, yaitu penurunan kemampuan model ketika mempelajari tugas atau informasi tambahan. Terinspirasi dari proses konsolidasi ingatan manusia saat tidur, kerangka Sleep menggabungkan pembelajaran aktif dan penguatan memori secara berkala. Inovasi TEKNOLOGI tersebut membuka peluang pengembangan model bahasa besar yang lebih adaptif, mampu mempertahankan pengetahuan jangka panjang, serta meningkatkan kemampuan penalaran melalui proses pembelajaran berkelanjutan.
research.google+1
Google Research Memperkenalkan Kerangka Sleep untuk Pembelajaran AI
Para ilmuwan Google Research mengusulkan sistem pengelolaan memori AI yang disebut Sleep untuk membantu memperbaiki kemampuan pembelajaran jangka panjang. Pengembangan kerangka ini diumumkan dalam pembahasan penelitian Oktober 2026 oleh peneliti Google Research Ali Behrouz serta Vahab Mirrokni. Sasaran penting pengembangan adalah mendukung pembelajaran tanpa harus mengabaikan kemampuan terdahulu. Pada sebagian besar model bahasa modern, pengetahuan model dibentuk melalui proses pretraining. Setelah tahap tersebut, informasi terbaru tidak otomatis masuk ke parameter model. Kerangka Sleep berusaha menjembatani proses penggunaan dan pembelajaran.
Salah satu masalah penting adalah catastrophic forgetting. Kondisi ini muncul ketika sistem dilatih kembali dengan kumpulan data baru. Dalam beberapa keadaan, kinerja pada tugas lama berpotensi memburuk. Untuk menggambarkan situasinya, model yang mempelajari istilah teknis baru mungkin kehilangan sebagian keterampilan yang telah dikuasai. Kerangka Sleep mencoba mengatasinya melalui mekanisme pemindahan informasi menuju penyimpanan jangka panjang. Melalui rancangan pembelajaran ini, model berpotensi mempertahankan kemampuan terdahulu.
Cara Kerja Fase Wake dan Sleep dalam Model Kecerdasan Buatan
Sistem pengelolaan memori AI tersebut menerapkan siklus aktivitas dengan tahapan berbeda, yaitu fase wake dan sleep. Ketika sistem berada dalam kondisi aktif, model menerima dan memproses informasi pengguna. Data relevan dari aktivitas tersebut dipertahankan dalam struktur memori berfrekuensi tinggi. Periode pemrosesan langsung tersebut menggambarkan kondisi ketika sistem memperoleh informasi. Namun demikian, sistem tidak memiliki proses tidur seperti makhluk hidup. Seluruh aktivitas tersebut berjalan menggunakan aturan dan arsitektur komputasi.
Saat sistem beralih menuju tahap tidur, model menghentikan sementara penerimaan tugas baru. Proses internal model setelah itu digunakan untuk mengintegrasikan informasi. Melalui mekanisme pembelajaran offline, memori baru diperkuat melalui penyesuaian bobot tertentu. Mekanisme tersebut mengambil analogi dari proses penguatan memori saat beristirahat. Namun, pengolahan AI tetap menggunakan perhitungan matematis. Berkat pengaturan siklus pembelajaran, pembelajaran dapat dikelola dalam periode khusus. Keterbatasannya adalah kebutuhan waktu komputasi tambahan selama fase offline.
Memory Consolidation Menggunakan Mixture of Experts dan Knowledge Seeding
Tahap memory consolidation merupakan fondasi pembelajaran jangka panjang yang diusulkan. Ketika konsolidasi berlangsung, pembelajaran dilakukan melalui komponen MoE. Pendekatan pemrosesan tersebut menyediakan kelompok parameter dengan fungsi tertentu. Dalam rancangan Sleep digunakan penambahan kapasitas parameter secara terkontrol agar pengetahuan tambahan tidak langsung menimpa seluruh parameter lama. Bagian jaringan yang diaktifkan memanfaatkan parameter berdimensi rendah untuk membantu menekan kebutuhan sumber daya. Dengan mekanisme tersebut, pengetahuan lama berpotensi lebih terlindungi.
Sebagai tahapan konsolidasi berikutnya, sistem menggunakan proses knowledge seeding. Pendekatan penguatan memori tersebut bertujuan memindahkan pengetahuan sementara menuju parameter jangka panjang. Melalui proses pembelajaran tersebut, sistem memanfaatkan GKD bersama pembelajaran imitasi berbasis reinforcement learning. Informasi yang dipelajari memperhitungkan karakteristik semantik respons. Sesudah pemindahan pengetahuan dilakukan, komponen berfrekuensi tinggi dapat dikosongkan melalui tahapan pemangkasan sinaptik secara komputasional. Pengaturan memori ini mendukung keberlanjutan proses pembelajaran.
Simulasi Pengalaman Sintetis dalam Kerangka Sleep Google
Di samping penguatan pengetahuan jangka panjang, pendekatan Google menggunakan tahapan simulasi pembelajaran. Istilah dreaming menggambarkan aktivitas menghasilkan latihan buatan. Dalam tahapan dreaming, AI menyusun skenario pembelajaran buatan untuk mengeksplorasi hubungan pengetahuan. Pendekatan teknis yang digunakan adalah pemilihan modul ahli secara acak. Berkat perubahan jalur pemrosesan, latihan sintetis dapat mencakup kombinasi pengetahuan yang beragam. Proses ini membantu menghindari latihan yang terlalu seragam.
Materi pembelajaran buatan tersebut tidak langsung digunakan seluruhnya. Peneliti menerapkan mekanisme gradient-based data selection untuk memprioritaskan data dengan sinyal pembelajaran tinggi. Sesudah data latihan dievaluasi, sistem menggunakan penyesuaian model berbasis contoh terpilih. Tahapan optimasi berikutnya juga memanfaatkan reinforcement learning untuk menilai dampak latihan terhadap performa. Walaupun proses ini menjanjikan, contoh latihan buatan tidak otomatis selalu benar. Ketika data latihan tidak cukup akurat, proses optimasi dapat menghasilkan perilaku yang tidak diinginkan. Oleh sebab itu, proses seleksi dan pengujian tetap menjadi kebutuhan utama.
Kemampuan Model AI Mempertahankan Informasi hingga Jutaan Token
Dalam hasil eksperimennya tim peneliti menjelaskan, sistem konsolidasi memori menunjukkan kemampuan pada beberapa benchmark. Evaluasi yang mendapat perhatian berkaitan dengan penyimpanan pengetahuan dalam skala jutaan token. Melalui benchmark BABILong, sistem menunjukkan hasil pada konteks mencapai sepuluh juta token. Pencapaian yang dilaporkan berkaitan dengan konsolidasi informasi ke parameter model. Meski hasilnya menarik, kemampuan tersebut belum membuktikan ketahanan memori pada seluruh penggunaan nyata. Dengan pertimbangan tersebut, hasil penelitian perlu dipahami sesuai konteks pengujiannya.
Selain pengujian konteks panjang, kerangka Sleep diuji pada pembelajaran bahasa. Dalam pengujian tersebut, sistem mempelajari bahasa tambahan secara berurutan. Tim peneliti menyampaikan, proses pembelajaran menunjukkan gangguan minimal pada tugas terdahulu. Penelitian juga mencakup eksperimen penyimpanan informasi baru. Pada benchmark terkait, pengujian single-task menunjukkan skor 48,9 persen. Di sisi pembelajaran lanjutan, skor yang diperoleh sebesar 46,2 persen. Angka tersebut tidak boleh dianggap sebagai tingkat akurasi universal.
Keterbatasan Teknis Kerangka Sleep Sebelum Digunakan Secara Luas
Jika pendekatan Sleep terus berkembang, pengembang berpeluang membangun layanan yang lebih responsif terhadap informasi baru. Salah satu contoh penggunaan adalah aplikasi pendukung produktivitas organisasi. Pada aktivitas bisnis, kebijakan perusahaan mengalami penyesuaian. Dengan pembelajaran berkelanjutan, asisten AI berpotensi mempertahankan pengetahuan sebelumnya. Potensi adaptasi ini juga dapat mendukung sistem analisis pengetahuan. Namun demikian, hasil eksperimen belum menunjukkan penerapan umum pada seluruh asisten digital.
Pengembangan sistem pembelajaran berkelanjutan masih membutuhkan evaluasi lebih mendalam. Salah satu persoalan penting adalah biaya komputasi selama fase sleep. Selama proses pembelajaran internal berlangsung, proses pelatihan membutuhkan waktu serta energi. Sebagai tantangan berikutnya, keamanan data yang dipelajari harus dijaga. Apabila model menyimpan pengetahuan baru dalam parameter, pengembang harus mempertimbangkan pengendalian data pribadi. Pemeriksaan kemampuan lama setelah pembaruan juga menjadi bagian penting pengembangan. Berkat pengawasan teknis yang tepat, manfaat pembelajaran berkelanjutan dapat dinilai secara lebih bertanggung jawab.
Masa Depan Model AI dengan Kemampuan Pembelajaran Berkelanjutan
Inovasi konsolidasi memori AI melalui Sleep menjadi langkah penelitian penting dalam continual learning. Melalui pembagian fase wake dan sleep, pembaruan informasi dapat dikelola menggunakan mekanisme khusus. Penguatan parameter jangka panjang bersama simulasi latihan sintetis membuka peluang perbaikan kemampuan AI. Hasil pengujian pada konteks hingga 10 juta token serta kemajuan dalam pengujian kemampuan faktual menjadi dasar penelitian lanjutan. Namun demikian, keandalan dalam penggunaan nyata harus terus diteliti.
Di tengah inovasi TEKNOLOGI model bahasa, adaptasi terhadap informasi baru menjadi kebutuhan utama. Pendekatan konsolidasi memori ini menggambarkan bahwa pembelajaran AI tidak harus berhenti setelah pretraining. Meski demikian, keamanan informasi dan biaya komputasi tetap perlu diperhatikan. Dengan penelitian lanjutan, sistem pembelajaran berkelanjutan mungkin semakin matang. Berdasarkan ketertarikan Anda terhadap kecerdasan buatan, seberapa penting kemampuan pembelajaran berkelanjutan bagi asisten AI? Anda dapat berbagi pengalaman dan pemikiran mengenai kerangka Sleep Google.